博客

小山出题博客,涵盖系统更新、技术分享和重要公告。

文章分类

当前分类:model

  1. 模型覆盖说明

    发布时间:2026-04-01

    分类:模型资讯

    作者:洛小山

    模型覆盖说明 XSCT Arena 持续接入主流大模型,覆盖语言、代码、图像生成、多模态等多种类型,所有模型均经过统一评测标准打分,结果公开可查。 本文档记录各模型的上线时间,方便了解平台的模型覆盖进展。 --- 当前覆盖模型 语言模型 | 模型 | 厂商 | 上线日期 | |------|------|----------| | Qwen3.6-Plus-Preview | 阿里云 |...

    阅读全文
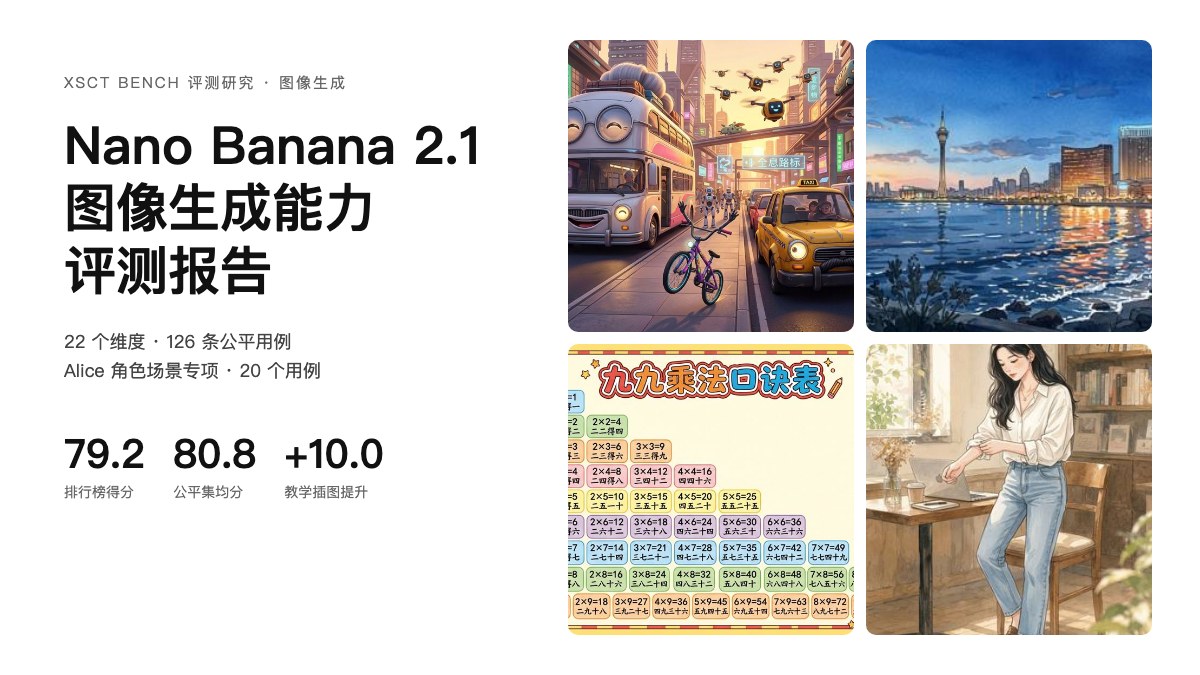
  2. Nano Banana 2.1 图像生成能力评测报告

    发布时间:2026-10-07

    分类:模型资讯

    作者:洛小山

    一句话结论:Nano Banana 2.1 排行榜 79.2 分(第 5/21),公平集均分 80.8,较 Nano Banana 2 高 1.9 分;教学插图提升 10.0 分,动作维度退步;Alice 角色场景 80.8 分,低于 GPT Image 2 与 Image 2.5,弱项在双参考图试穿与人物一致性。

    阅读全文
  3. Gemini 3.5 Flash 深度测评报告

    发布时间:2026-05-28

    分类:模型资讯

    作者:洛小山

    一句话结论:Gemini 3.5 Flash 付费层定价 $1.50/$9.00(输入/输出每百万 token),阅读理解(97.1)和数学推理(95.9)基础功底扎实,但批判思维天花板仅 1 级(68.1)、难度退化幅度过大(中文拼音 -15.9)

    阅读全文
  4. 小米 mimo-v2.5 / mimo-v2.5-pro 深度测评报告

    发布时间:2026-04-29

    分类:模型资讯

    作者:洛小山

    结论一:综合定位——中游水平,与头部差距 5–7 分。 mimo-v2.5 综合 84.9 位列 #23/30,与 #1 kimi-k2.6(91.5)差距 6.6 分,与 #4 deepseek-v4-pro(90.0)差距 5.1 分。这一差距属于"有意义"(5–9 分)的级别,表明 mimo-v2.5 尚未进入第一梯队,但也并非不可追赶。

    阅读全文
  5. GLM-5.1 vs DeepSeek-V4-Pro 综合测评报告

    发布时间:2026-04-25

    分类:模型资讯

    作者:洛小山

    阅读全文
  6. GPT-5.5深度测评报告

    发布时间:2026-04-24

    分类:模型资讯

    作者:洛小山

    GPT-5.5 是一台"会答难题、但不擅长答简单题"的模型。它的数学硬题和推理链属于第一梯队,代码能力接近 Claude,但在 长文档理解、Agent/MCP 调用、批判性思考这三项上明显落后 kimi-k2.6。 更关键的是,这些短板没有因为它多出的 12 倍价格而被补上。

    阅读全文
  7. DeepSeek V4 系列深度测评

    发布时间:2026-04-24

    分类:模型资讯

    作者:洛小山

    V4-Pro 已经挤进了全球前 5;V4-Flash 用 1/12 的价格摸到了第二梯队顶端。看起来像是一套"高精度 + 极低成本"的双层组合——不过后面几节会看到,这两者并不是简单的等比例缩放关系,Flash 在某些地方反而更强,Pro 在某些地方拉开得很开。

    阅读全文
  8. GPT-Image-2 全量上线,中文顶到爆,50+ Case 生图实测

    发布时间:2026-04-21

    分类:模型资讯

    作者:赛博禅心

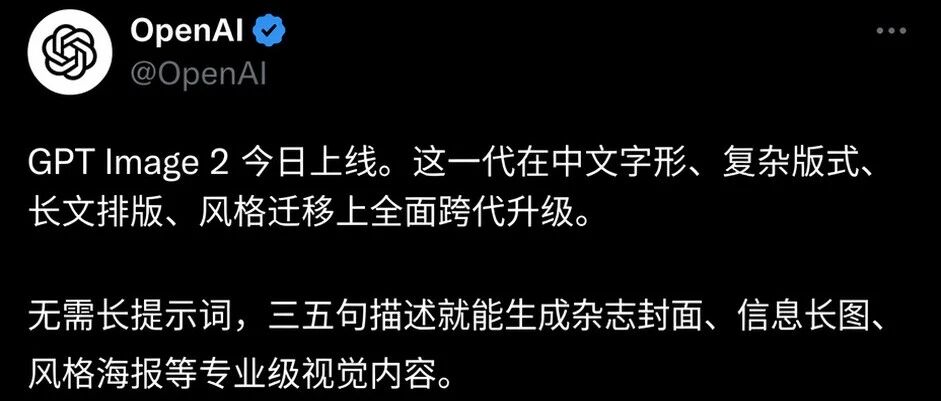
    太牛逼了 刚刚,GPT-Image-2 正式全量上线,有图为证 !图片 等等...我得说一下,发布信息是我用 GPT-Image-2 自己画出来的,提示词是这个 提示词画一张 X 推特截图,@OpenAI 蓝勾认证账号发推,深色模式。正文「ChatGPT Image 2...

    阅读全文
  9. Kimi K2.6深度测评报告

    发布时间:2026-04-21

    分类:模型资讯

    作者:洛小山

    Kimi K2.6 以「推理型特征 + 越难越稳」夺得文本理解榜首,在 Writing/ReasoningChain 展现同代最佳规则一致性;但 Agent 工具链路和严格格式指令遵循仍是其阻挡全面碾压第一梯队的两堵墙——国产旗舰的上限已逼近 Claude,但下限偶尔会滑到第二梯队。

    阅读全文
  10. Claude Opus 4.7 的正确姿势:把 Claude 当「工程师」,而不是「实习生」

    发布时间:2026-04-19

    分类:模型资讯

    作者:洛小山

    Claude Opus 4.7 的正确姿势:把 Claude 当「工程师」,而不是「实习生」 > 多数人用 Opus 4.7 时只发挥了它 30% 的实力——不是模型不行,而是交互范式还停留在「结对编程」时代。本文从委派模式、Effort 档位、自适应思考三个维度,讲清楚怎么让它真正干活。 --- 一、范式转变:把 Claude 当「工程师」,而不是「实习生」...

    阅读全文
相关链接

博客

系统更新、技术分享和重要公告

模型覆盖说明
置顶 模型资讯 2026-04-01

模型覆盖说明

模型覆盖说明 XSCT Arena 持续接入主流大模型,覆盖语言、代码、图像生成、多模态等多种类型,所有模型均经过统一评测标准打分,结果公开可查。 本文档记录各模型的上线时间,方便了解平台的模型覆盖进展。 --- 当前覆盖模型 语言模型 | 模型 | 厂商 | 上线日期 | |------|------|----------| | Qwen3.6-Plus-Preview | 阿里云 |...

Nano Banana 2.1 图像生成能力评测报告
模型资讯 2026-10-07

Nano Banana 2.1 图像生成能力评测报告

一句话结论:Nano Banana 2.1 排行榜 79.2 分(第 5/21),公平集均分 80.8,较 Nano Banana 2 高 1.9 分;教学插图提升 10.0 分,动作维度退步;Alice 角色场景 80.8 分,低于 GPT Image 2 与 Image 2.5,弱项在双参考图试穿与人物一致性。

Gemini 3.5 Flash 深度测评报告
模型资讯 2026-05-28

Gemini 3.5 Flash 深度测评报告

一句话结论:Gemini 3.5 Flash 付费层定价 $1.50/$9.00(输入/输出每百万 token),阅读理解(97.1)和数学推理(95.9)基础功底扎实,但批判思维天花板仅 1 级(68.1)、难度退化幅度过大(中文拼音 -15.9)

小米 mimo-v2.5 / mimo-v2.5-pro 深度测评报告
模型资讯 2026-04-29

小米 mimo-v2.5 / mimo-v2.5-pro 深度测评报告

结论一:综合定位——中游水平,与头部差距 5–7 分。 mimo-v2.5 综合 84.9 位列 #23/30,与 #1 kimi-k2.6(91.5)差距 6.6 分,与 #4 deepseek-v4-pro(90.0)差距 5.1 分。这一差距属于"有意义"(5–9 分)的级别,表明 mimo-v2.5 尚未进入第一梯队,但也并非不可追赶。

GPT-5.5深度测评报告
模型资讯 2026-04-24

GPT-5.5深度测评报告

GPT-5.5 是一台"会答难题、但不擅长答简单题"的模型。它的数学硬题和推理链属于第一梯队,代码能力接近 Claude,但在 长文档理解、Agent/MCP 调用、批判性思考这三项上明显落后 kimi-k2.6。 更关键的是,这些短板没有因为它多出的 12 倍价格而被补上。

DeepSeek V4 系列深度测评
模型资讯 2026-04-24

DeepSeek V4 系列深度测评

V4-Pro 已经挤进了全球前 5;V4-Flash 用 1/12 的价格摸到了第二梯队顶端。看起来像是一套"高精度 + 极低成本"的双层组合——不过后面几节会看到,这两者并不是简单的等比例缩放关系,Flash 在某些地方反而更强,Pro 在某些地方拉开得很开。

GPT-Image-2 全量上线,中文顶到爆,50+ Case 生图实测
模型资讯 2026-04-21

GPT-Image-2 全量上线,中文顶到爆,50+ Case 生图实测

太牛逼了 刚刚,GPT-Image-2 正式全量上线,有图为证 !图片 等等...我得说一下,发布信息是我用 GPT-Image-2 自己画出来的,提示词是这个 提示词画一张 X 推特截图,@OpenAI 蓝勾认证账号发推,深色模式。正文「ChatGPT Image 2...

Kimi K2.6深度测评报告
模型资讯 2026-04-21

Kimi K2.6深度测评报告

Kimi K2.6 以「推理型特征 + 越难越稳」夺得文本理解榜首,在 Writing/ReasoningChain 展现同代最佳规则一致性;但 Agent 工具链路和严格格式指令遵循仍是其阻挡全面碾压第一梯队的两堵墙——国产旗舰的上限已逼近 Claude,但下限偶尔会滑到第二梯队。

Claude Opus 4.7 的正确姿势:把 Claude 当「工程师」,而不是「实习生」
模型资讯 2026-04-19

Claude Opus 4.7 的正确姿势:把 Claude 当「工程师」,而不是「实习生」

Claude Opus 4.7 的正确姿势:把 Claude 当「工程师」,而不是「实习生」 > 多数人用 Opus 4.7 时只发挥了它 30% 的实力——不是模型不行,而是交互范式还停留在「结对编程」时代。本文从委派模式、Effort 档位、自适应思考三个维度,讲清楚怎么让它真正干活。 --- 一、范式转变:把 Claude 当「工程师」,而不是「实习生」...